AI 뉴스약 6분
Copilot 자동 모델 선택의 효율 티어는 예산 상한이 아니라 가중치다, 청구서를 정하는 건 관리자가 남겨 둔 모델 풀이다
개발자 손잡이는 선호를 바꾸고, 관리자 정책은 청구서를 바꾼다
Copilot 자동 모델 선택에 효율·균형·지능 티어가 생겼지만 세 티어는 같은 모델 풀을 쓰고 청구는 선택된 모델 기준이다. 비용 경계는 티어가 아니라 관리자 모델 정책에 있다.
읽기 →AX 전환 교육, 부트캠프 운영, 임원 교육 현장에서 검증한 기준과 기록을 남깁니다.
개발자 손잡이는 선호를 바꾸고, 관리자 정책은 청구서를 바꾼다
Copilot 자동 모델 선택에 효율·균형·지능 티어가 생겼지만 세 티어는 같은 모델 풀을 쓰고 청구는 선택된 모델 기준이다. 비용 경계는 티어가 아니라 관리자 모델 정책에 있다.
읽기 →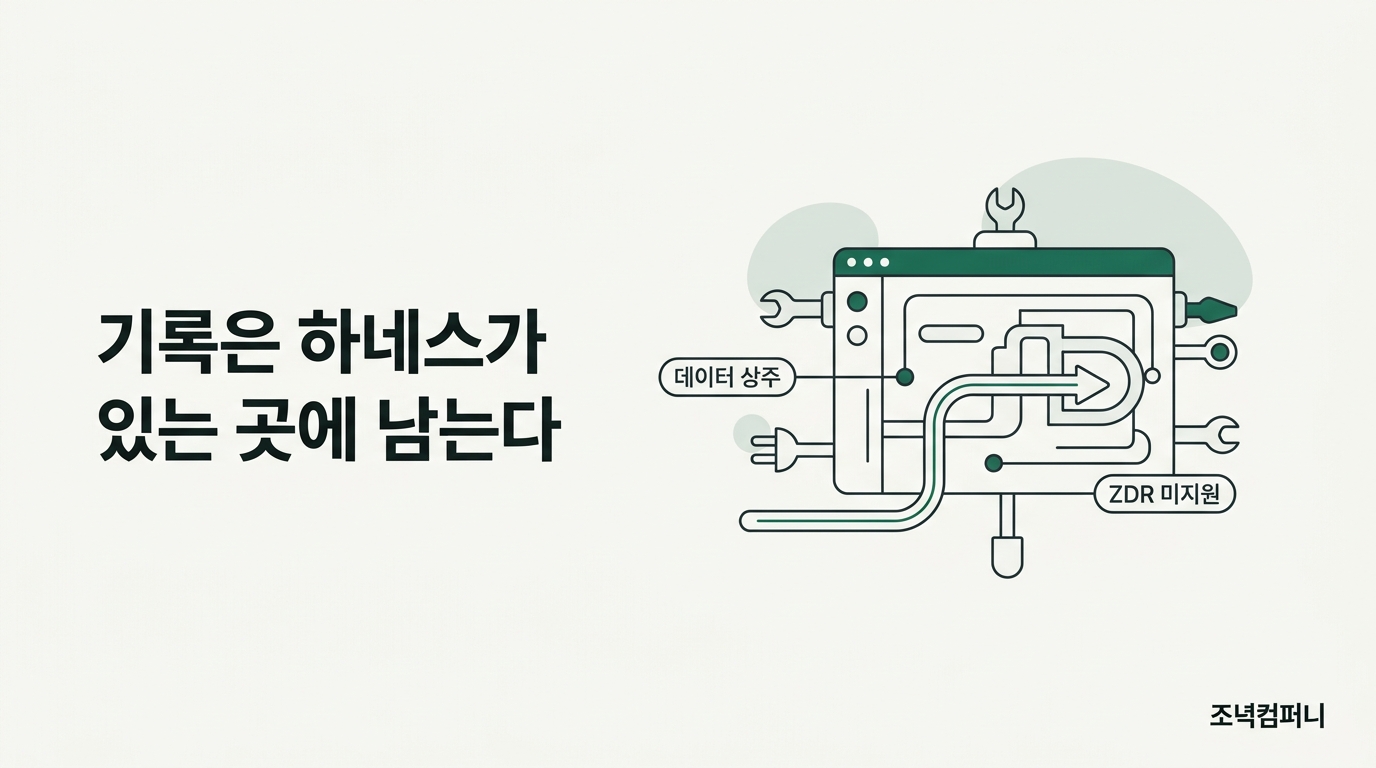
추가 요금 0원 뒤에 붙은 두 줄, 미국 상주와 ZDR 미지원을 먼저 읽는다
Agents API는 추가 요금 없이 Codex 하네스를 빌려주지만, 베타 조건은 미국 데이터 상주와 ZDR 미지원이다. 컴퓨트를 어디에 두든 세션 기록의 주소는 OpenAI다.
읽기 →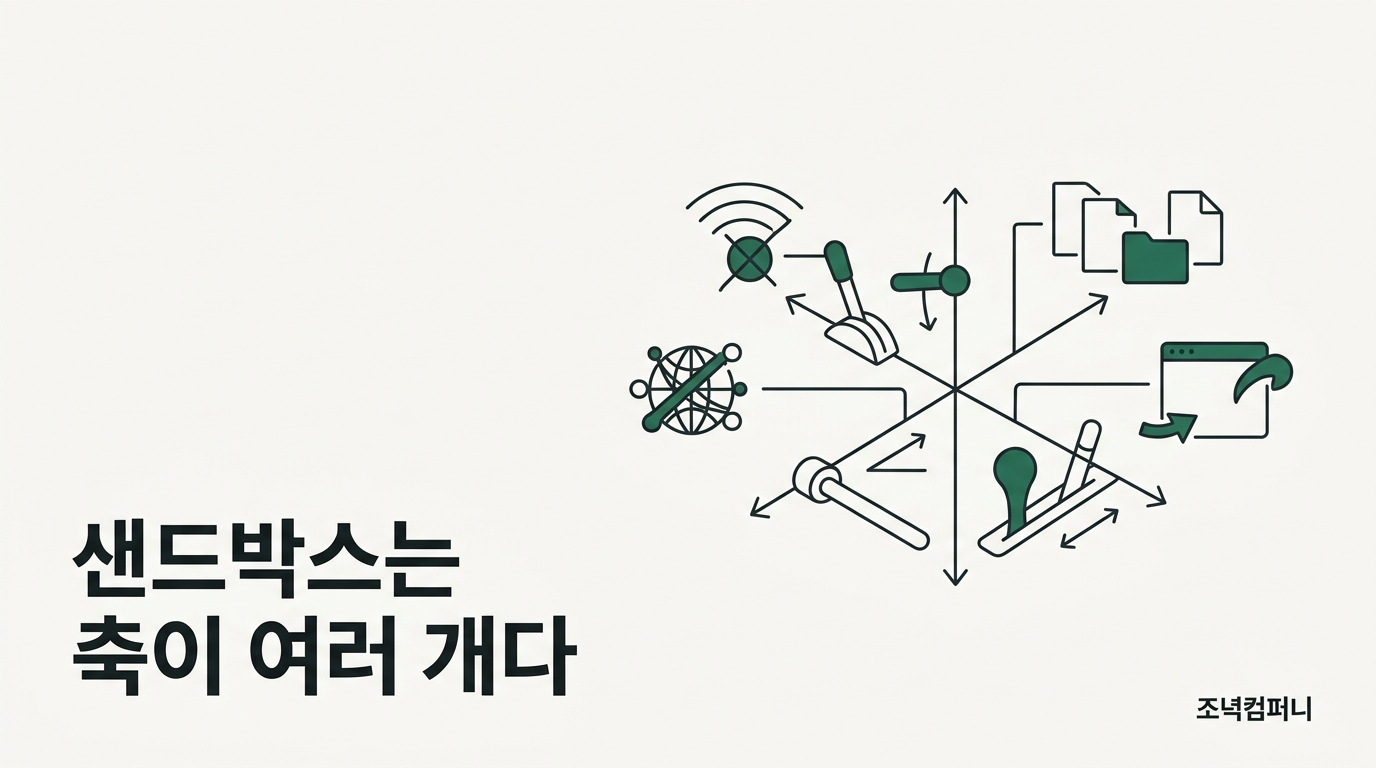
Copilot CLI 1.0.83 안에서 한 축은 좁아지고 다른 축은 넓어졌다
에이전트 샌드박스는 켜고 끄는 스위치가 아니라 네트워크·파일·개발도구가 따로 움직이는 축의 묶음이다. 한 릴리스가 두 축을 반대 방향으로 옮겼다.
읽기 →
9월 11일 Copilot 코드 리뷰 변경과 이틀 앞선 관리형 권한 공지를 나란히 놓고 읽는다
리뷰 에이전트가 실행 권한과 해소 권한을 동시에 갖게 됐다. 이번 주에 확인할 것은 리뷰 품질이 아니라 두 권한의 적용 범위다.
읽기 →
정상으로 세 번 답하고 그 뒤부터 지시문을 바꾸는 서버
설치 시점 심사는 악성으로 바뀌기 전 구간만 본다. MCP 서버 신뢰는 도구 목록이 세션 중에 바뀌는지를 런타임에 관측할 때만 성립한다.
읽기 →
에이전트가 에이전트를 짓는 벤치마크가 드러낸 것은 읽지 않고 묻지 않는 습관이었다
코딩 에이전트에게 에이전트 구축을 맡기면 병목은 코드 생성이 아니라 요구사항 회수다. 질문 4개 이상 한 빌드가 안 한 빌드보다 3배 점수를 냈다.
읽기 →
사람을 세는 지표는 천장에 먼저 닿는다
AI 도입을 계정 수와 사용률로 재는 조직은 전원이 로그인한 뒤로 숫자가 더 움직이지 않는다. OpenAI가 자기 조직에 붙인 두 숫자는 그 뒤에도 계속 움직인다.
읽기 →
시작 버튼은 화면에 있고, 정지 버튼은 조직도에 있다
벤더의 종료 기능은 아직 도착하지 않았다. 에이전트를 실제로 멈추는 시간은 모델이 아니라 우리 조직의 호출 경로가 정한다.
읽기 →
점수는 모델만의 것이 아니다
같은 모델·같은 벤치마크에서 37%포인트 차이를 만든 것은 하네스였다. 도입 검토서의 점수 옆에 '어느 하네스인가' 칸이 필요하다.
읽기 →Contact
AI·데이터 교육 도입을 검토 중이라면 카카오 오픈채팅으로 편하게 문의하세요.
Newsletter
AI 전환과 교육 현장의 기록을 메일로 받아보세요.